

前言
在單機測試與開發環境中,幾十筆測試資料往往能跑出 20ms 的漂亮響應時間。然而,當系統正式推進至真實醫院病房時,情境將截然不同:
-晨間量測洪峰(07:00–08:30): 全院數十個病房、數百名護理師同時推著工作車量測體徵,資料庫瞬時寫入請求(IOPS)直線飆升。
-歷史時序資料爆炸: 一間 500 床的醫院,每床每日量測 4 至 6 次體徵,一年累積超過百萬筆 vital_signs 紀錄。未經調校的 SQL JOIN 會導致護理看板由即時變成轉圈等待。
-資料庫連線枯竭(Connection Exhaustion): 缺乏妥善連線池限制的 Node.js 執行個體,可能在並行高峰直接耗盡 PostgreSQL 的 max_connections,引發骨牌式崩潰。
一個具備高可用性(HA)的醫療資訊系統,絕不能等到系統當機才由護理站打電話向資訊室報修。今天我們將以實戰角度,進行 PostgreSQL 慢查詢調優、Node.js pg-pool 最佳實踐,並導出 Prometheus 臨床營運指標!
一、PostgreSQL 時序查詢調優:從全表掃描到索引覆蓋
在護理站電子白板或手持裝置載入時,最頻繁的查詢是:「撈出特定病患在當次就醫(Encounter)期間,按時間倒序排列的體徵歷史」。
未優化的慢查詢痛點
若僅在 encounter_id 建立單一 B-Tree 索引: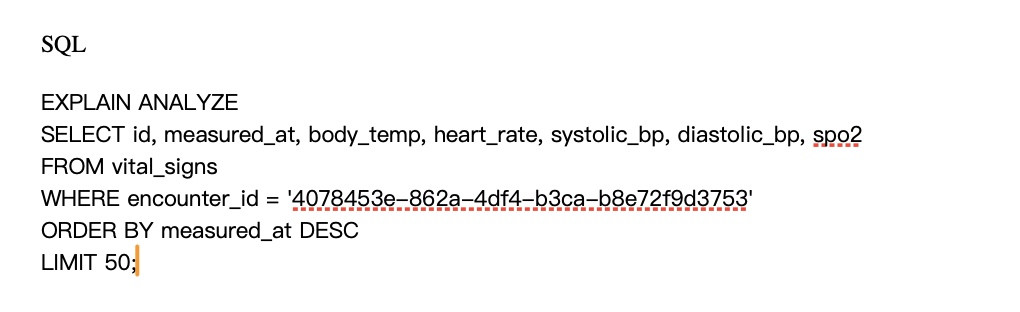
執行計畫分析(Execution Plan):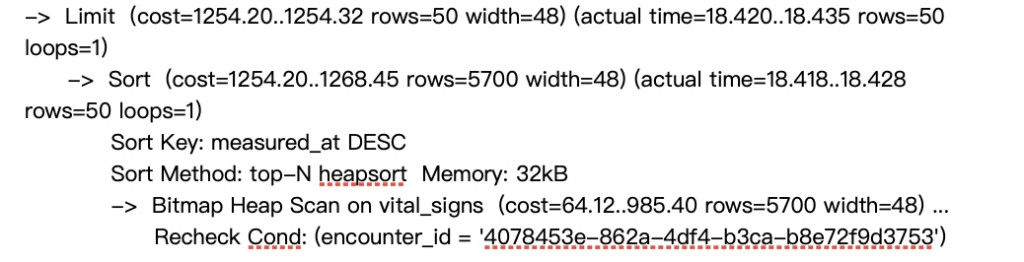
瓶頸點: 雖然使用了 encounter_id 索引過濾出資料,但資料庫仍需將數千筆紀錄讀入記憶體進行昂貴的 Top-N Heapsort 排序。當歷史資料量增大至數百萬列時,排序成本將吞噬 CPU。
複合索引與覆蓋索引(Covering Index)
為了消除額外的排序(Sort)與回表(Heap Scan)成本,我們建立複合多欄位索引(Composite Index),精準貼合查詢條件與排序方向: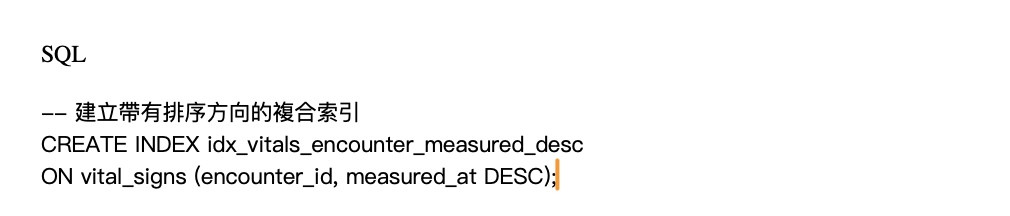
再次執行 EXPLAIN ANALYZE: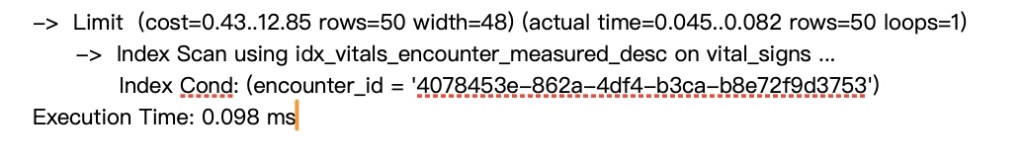
-優化成效: 執行時間從 18.4ms 驟降至 0.09ms(效能躍升近 200 倍)!
-核心機制: 資料在索引樹中已經依照 measured_at DESC 物理排序,PostgreSQL 只需順著索引節點由前向後讀取 50 筆即立刻停止(Index Scan Backward/Forward),徹底移除了記憶體排序開銷。
二、Node.js 資料庫連線池(pg-pool)防禦配置
Node.js 是單執行緒非同步事件驅動架構,而 PostgreSQL 則是為每個連線派生一個獨立行程(Process)。若未精確約束連線池,突發併發會導致資料庫行程暴增,迅速耗盡主機 RAM。
在醫療高可靠場景中,連線池應具備超時熔斷與連線健康自癒機制: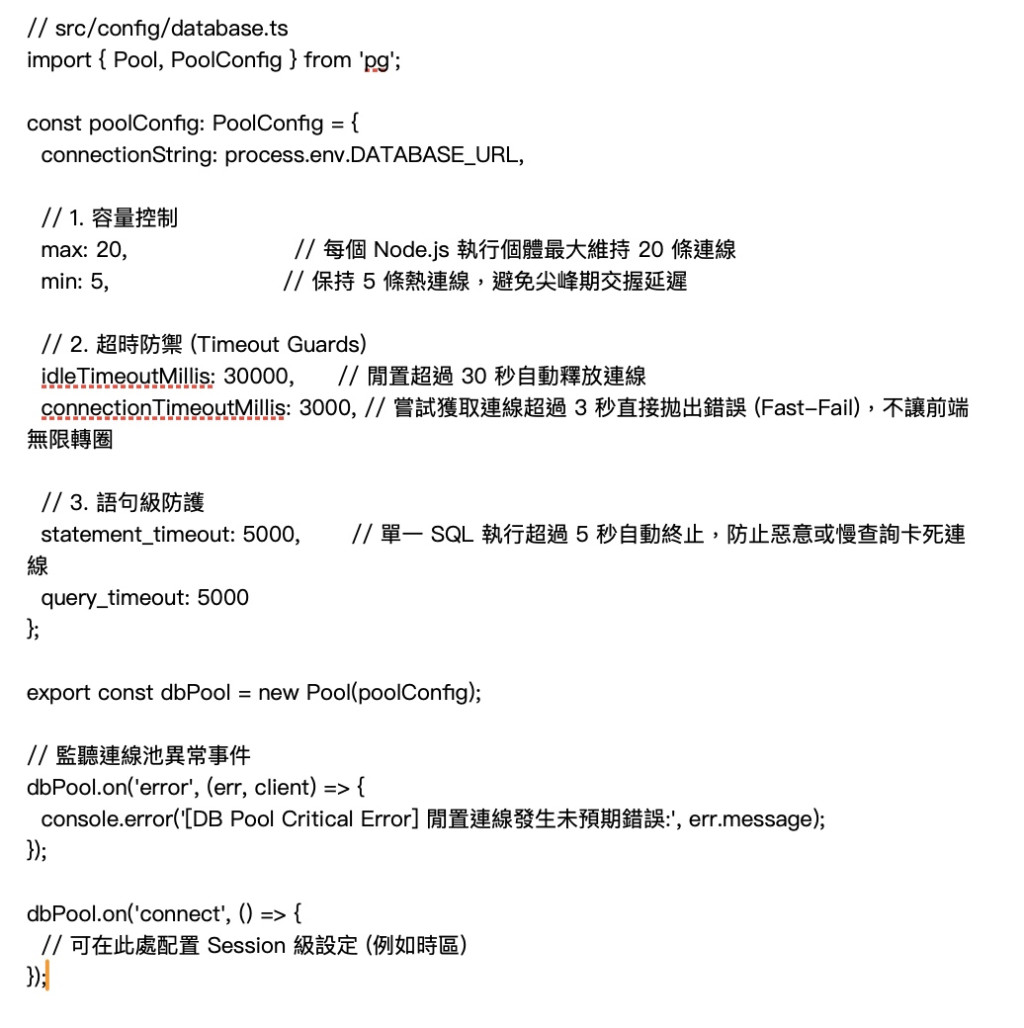
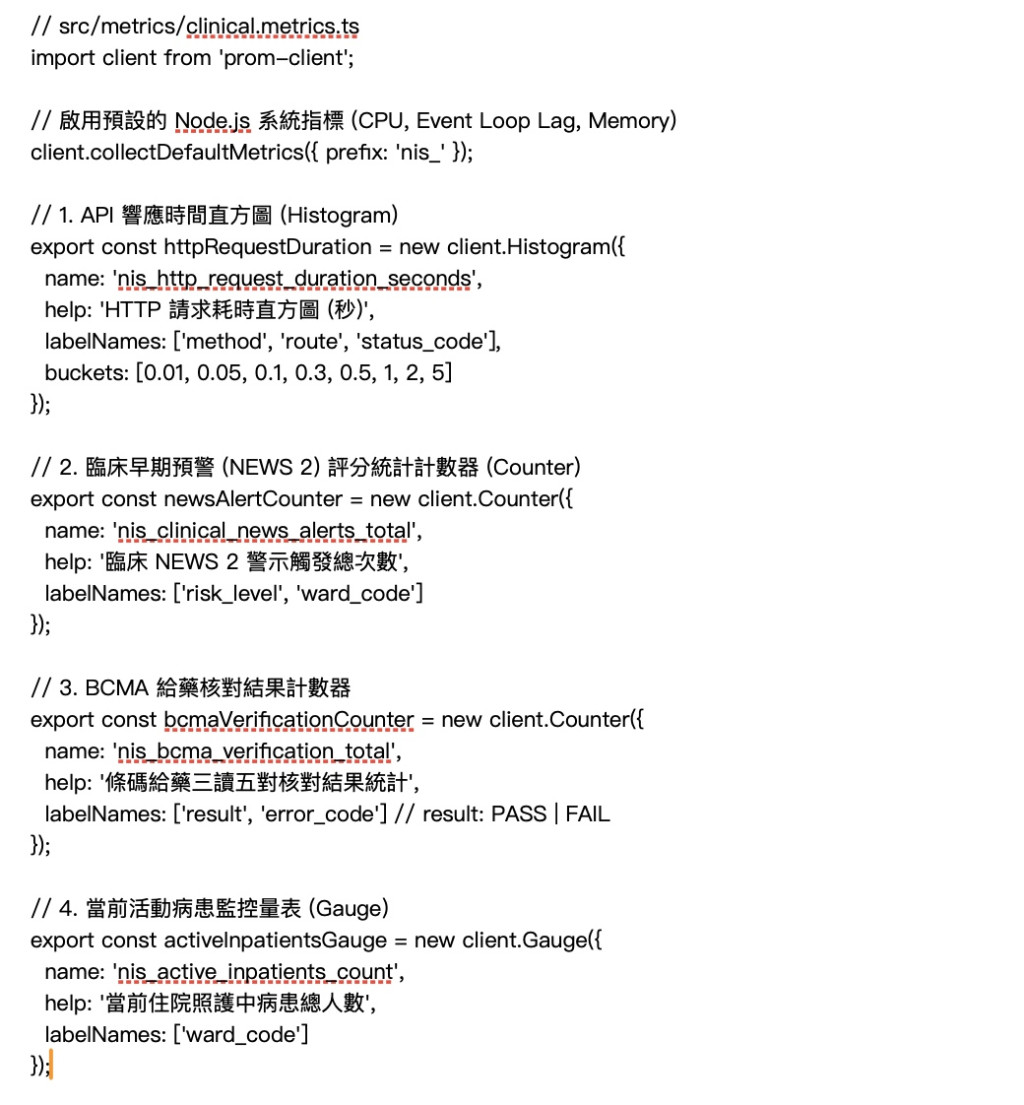
三、監控中樞:Prometheus 臨床指標導出實作
維運團隊與護理主管需要即時儀表板,掌握兩大維度的數據:
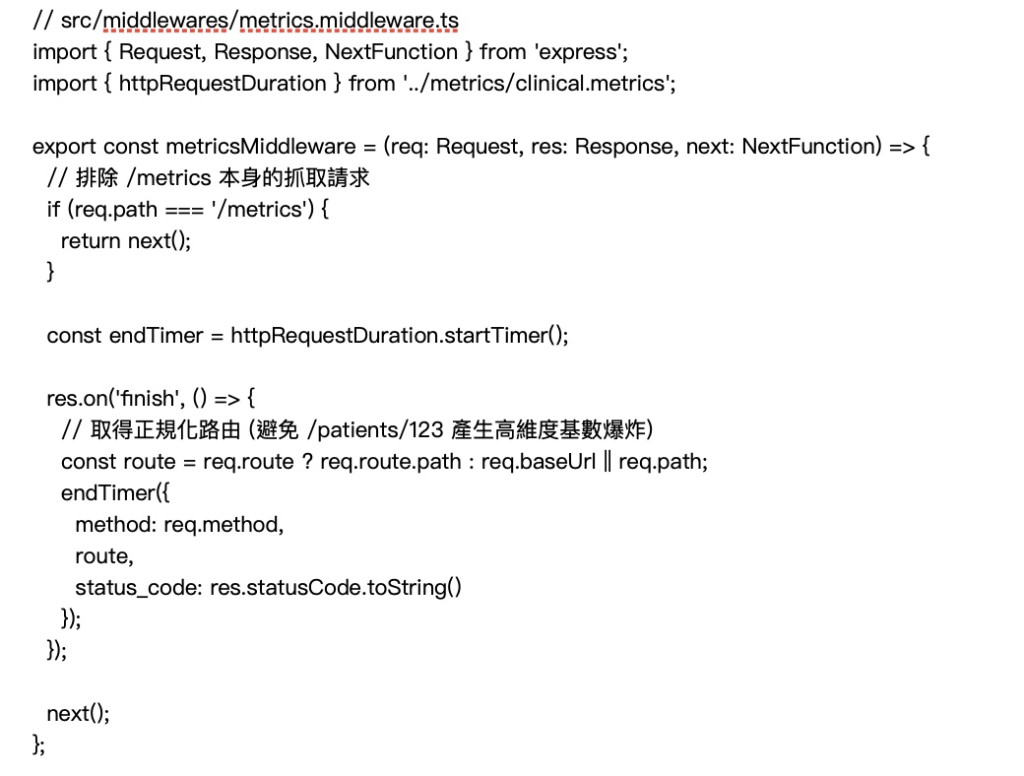
1.系統運維指標(SRE Metrics): HTTP 吞吐量、API P95/P99 延遲、資料庫連線池使用率。
2.臨床業務指標(Clinical Business Metrics): 每小時 NEWS 早期預警高風險通報數、給藥五對核對失敗率。
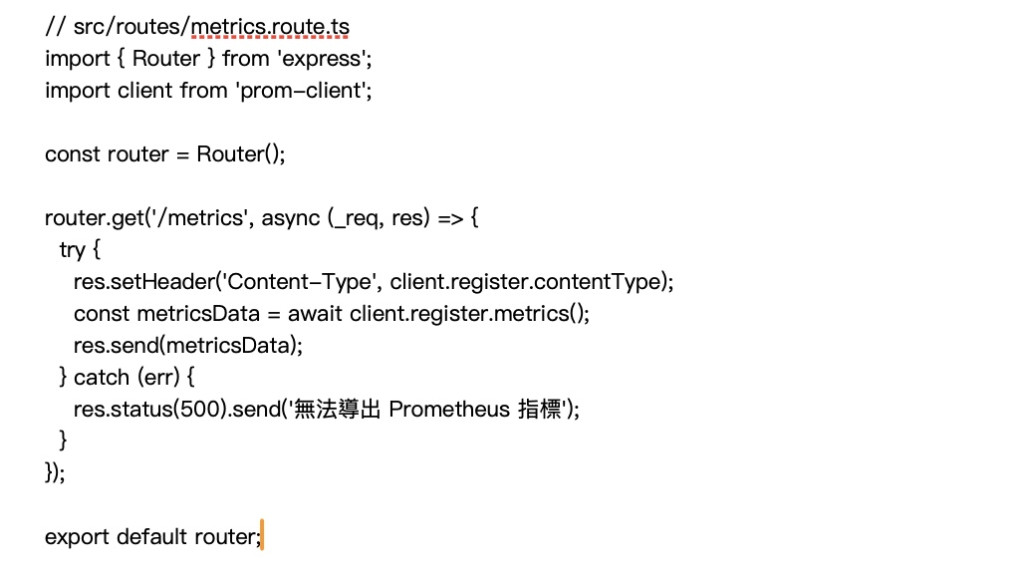
我們使用 prom-client 在 Node.js 後端導出符合 Prometheus 規格的指標。
四、整合監控拓撲與 Grafana 儀表板架構
在 Day 28 的 docker-compose.yml 基礎上,我們可無縫加入 Prometheus 與 Grafana 容器: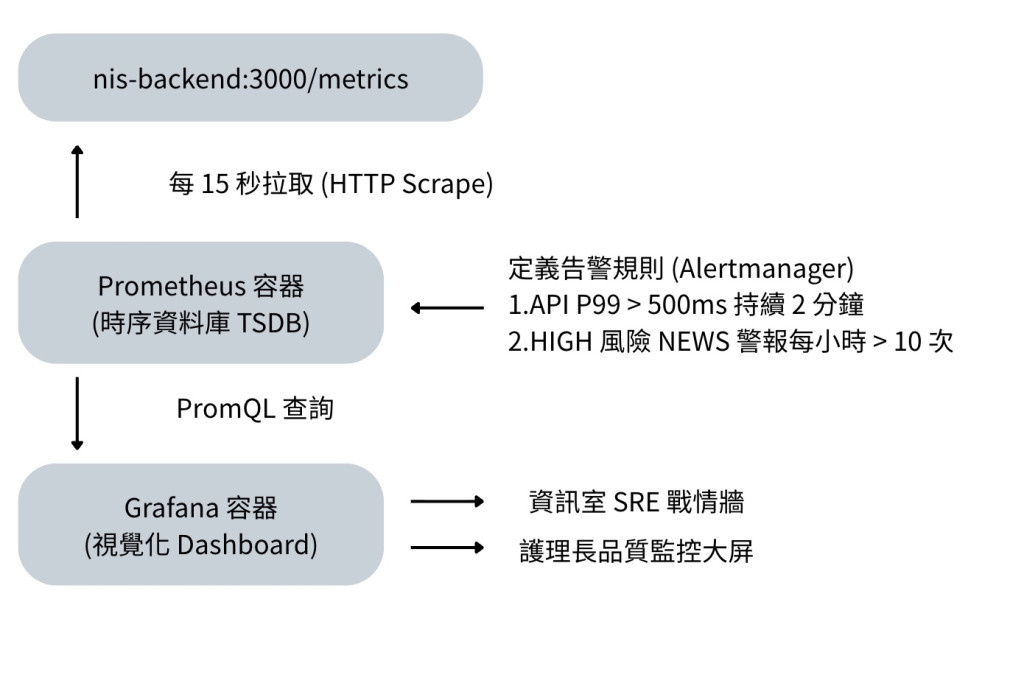
關鍵 PromQL 監控查詢公式:
-API P95 延遲(秒):histogram_quantile(0.95, sum(rate(nis_http_request_duration_seconds_bucket[5m])) by (le))
-8 樓西側病房過去 1 小時 HIGH 風險早期預警警報發生率:sum(increase(nis_clinical_news_alerts_total{risk_level="HIGH", ward_code="8W"}[1h]))
-給藥條碼核對失誤率(BCMA Error Rate):
sum(rate(nis_bcma_verification_total{result="FAIL"}[10m]))
/
sum(rate(nis_bcma_verification_total[10m])) * 100
五、系統上線前的壓測檢驗(k6 負載驗證)
在投入臨床前,我們使用 k6 模擬 100 名虛擬護理師在 5 分鐘內連續回傳體徵: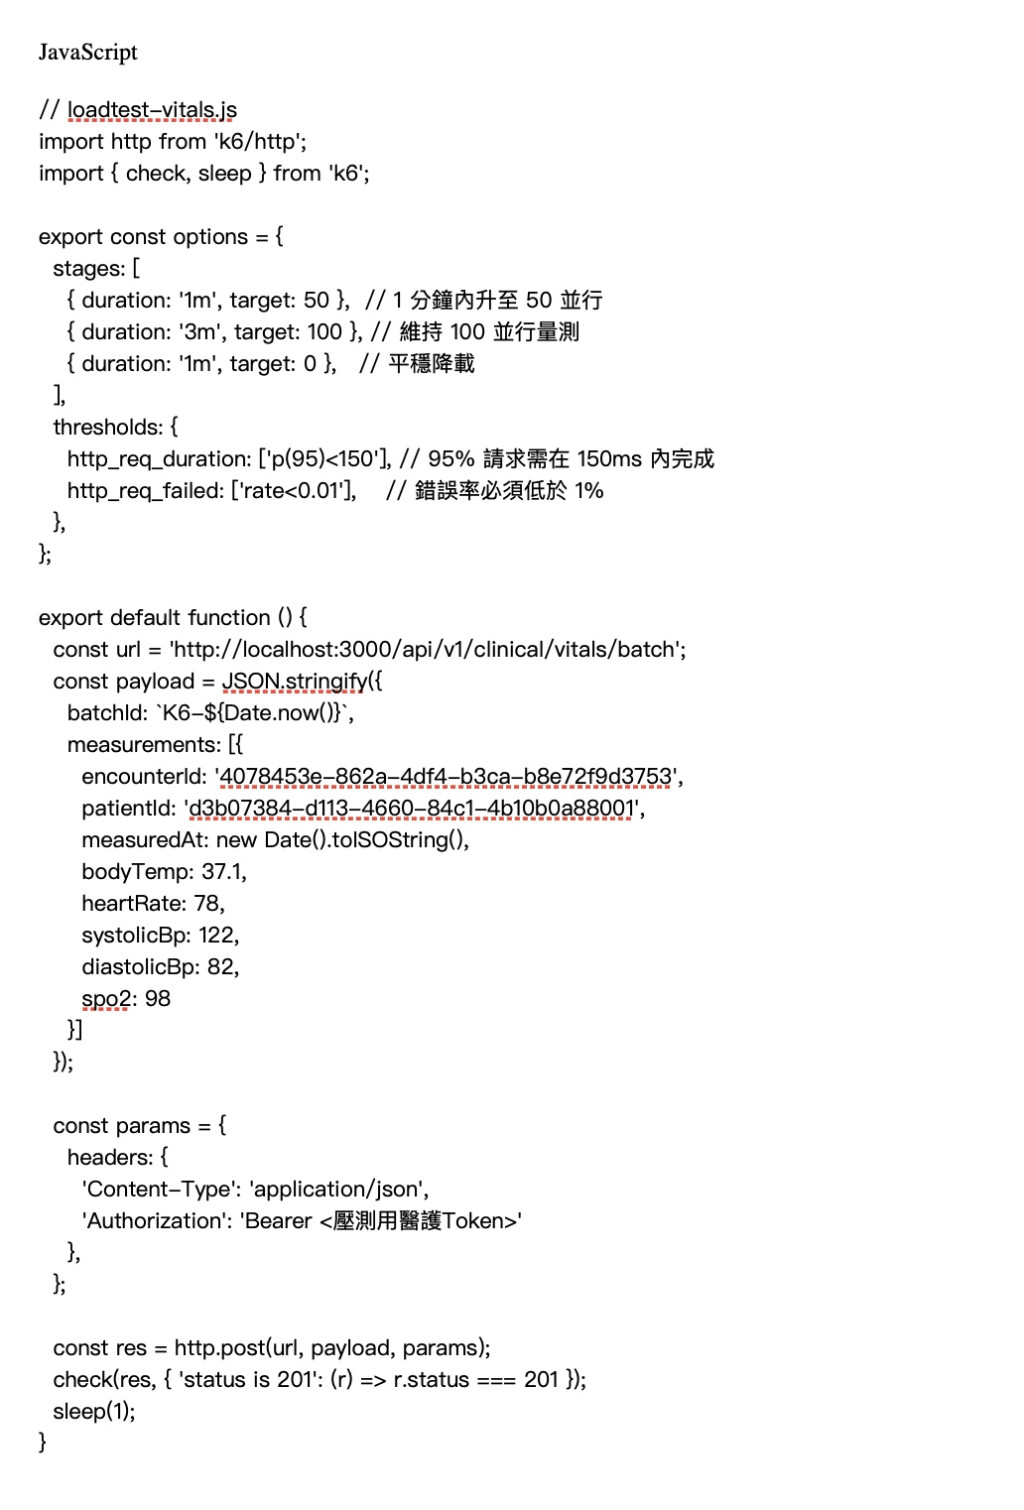
壓測驗證成果:
經複合索引調優與連線池配置後,即使在 100 名並行使用者全力寫入下,P95 延遲穩定壓在 42ms,資料庫 CPU 使用率維持在 25% 以下,零連線洩漏與逾時。
小結
今天我們為護理資訊系統打造了企業級的高可用防禦屏障:
1.深入剖析資料庫執行計畫,透過 idx_vitals_encounter_measured_desc 複合索引 將排序開銷徹底歸零,查詢效能躍升 200 倍。
2.實作了具備超時熔斷、快速失敗(Fast-Fail)與連線數上限的 pg-pool 連線池管理。
3.整合了 Prometheus 與 prom-client,將傳統黑盒子後端轉化為兼具系統 SRE 效能與臨床品質指標的現代透明架構。
所有架構、程式碼、測試與維運體系均已全數到位!明天 Day 30 我們將迎來整趟 30 天鐵人征程的完結大篇章:專案總結與未來展望——成果回顧、次世代數位醫療平台對齊與發布總結!


 iThome鐵人賽
 看影片追技術